


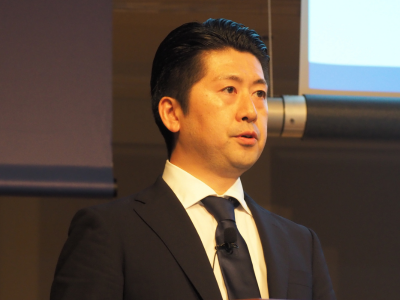


Cisco(シスコシステムズ)は2026年10月1日、都内でメディア向けのラウンドテーブルを開催した。テーマは、エンタープライズAIの現状と課題について。本国からグローバル業務全般を統括するティマヤ・スバイヤ(Thimaya Subaiya)氏が来日した。

ハードウェアからソフトウェアまで、AIインフラを構成する広範な製品ポートフォリオを有するCiscoだが、スバイヤ氏が今回共有したのは、同社の社内におけるAI活用の現況だ。現在、エンタープライズはAI活用をいかに効果・価値の創出へつなげられるかが問われるフェーズへ差し掛かりつつある。また、同時にセキュリティの新たなリスクも顕在化しており、攻めと守りの両面で具体的な対応を迫られている。
コロナ禍が明けて多くのLLMが登場した2023年頃、Ciscoは単一のAIモデルに依存しないという思想を体現した社内AIプラットフォーム「Circuit(サーキット)」を構築・導入した。特定のLLMに縛られない社内環境を整備した結果、全従業員の97%がAIを利活用し、一般的な社員で約6.5時間/週、エンジニアに至っては約8時間/週の業務時間削減を実現したという。
そして2026年8月、Circuitの次の進化段階として、同社は「MyAgent(マイエージェント)」を開発・導入した。これは、グローバル約9万人の従業員に提供されるパーソナルAIエージェントである。いわゆる、一人一台のAIパートナーと言ってよいだろう。Ciscoが持つコンピューティング、ストレージ、ネットワーク、セキュリティ、オブザーバビリティ、AIディフェンス、トークノミクスなどといった技術基盤の上に構築されている。Web、デスクトップ、モバイルのいずれからでも利用可能で、同社のコラボレーションツールであるWebex、さらにはブラウザ、メール上で機能する。

MyAgentは、単なる応答型のAIではない。永続的にメモリとコンテキストを保持し、与えられた目標に沿ってタスクを実行する自律型のパートナーだ。タスクの実行方法も単一ではなく、利用者からのプロンプトを解析し、決定論的なオートメーション(自動化)で処理すべきか、あるいはデータセンター内のローカルLLMで実行すべきか、それともフロンティアモデルを用いるべきか、自律的に判定を行う。これにより、1ユーザーあたりの利用コストを約10ドル程度/月に抑えているとのことだ。
セキュリティ&ガバナンスにおいては、社内の既存アプリケーションポリシーを適用し、エージェントの動作可能範囲を規程。システムが自律稼働している間も、常に人間が最終的なコントロールを握れるヒューマン・イン・ザ・コントロールの状態を確立しているとスバイヤ氏は説明した。加えて、MyAgentには営業、マーケティング、サポートなど様々なロール/タスクを担う750以上のサブエージェントが存在するが、これらは約150に及ぶMCPコネクタと連携しており、エージェントの無秩序な拡散を防ぐ仕組みになっているという。
インフラとセキュリティの融合にも注力している。2018年には約2.3年を要したサイバー攻撃のサイクルが8時間へと短縮される中で、Ciscoも67億行のコードスキャンを従来の12年から20週間へ短縮するなど、可能な限りリアルタイムでインフラを保護・統制していく技術を磨き続けているとスバイヤ氏はアピールした。
なお、MyAgentはそのまま外向け製品として顧客へ展開することは考えていないとのこと。顧客環境にAI基盤を構築する際は、Ciscoからインフラ部分を提供・支援し、そこから顧客側でMyAgentのような基盤を自前で構築していく流れになるとした。
MyAgentを運用する中で、Ciscoとしても多くの成果や発見を得られたという。たとえば営業部門では、市場状況やフォーキャストを常にモニタリングし、発注変更などが発生した際にはエージェントがサプライチェーンやファイナンスと自動で連携して調整を行う。これにより、従来は約5日かかっていた受発注変更処理が、約10分程度で完了するようになった。
ROIと生産性の面では、外部ソフトウェアベンダーへの依存度が大幅に下がったとスバイヤ氏。コスト削減はもちろんのこと、開発者のコードへのコミット頻度が増えたことで、バグや脆弱性が減少し、よりクリーンなコードを生成できるようになったと述べる。こうした改善が、顧客満足度やレスポンスタイムの向上にもつながっているようだ。
また、トークノミクス(トークン構造の最適化)を先駆けて実践する中でも、いくつかの知見を得られたという。同氏は、主な3つの知見を紹介した。
- LLMを頼るべき仕事は意外と少ない:確率論的なLLMを使わずとも、MLなどの決定論的なオートメーションで解決できてしまう作業は意外と多い。LLMを無駄に使わなければ、その分トークン消費は一切発生せず、大幅にトークン効率が向上する
- ローカルLLMで処理を完結する:外部のLLMへ都度送信するのではなく、Ciscoが自社で持つデータセンター内で運用するローカルLLMで処理を完結させることで、トークン効率を向上できる。Ciscoの自社データセンター内では現在、Google GemmaやMeta Llama、Mistral AIのMixtral、NVIDIAなどのオープンモデルが活用されている
- フロンティアモデル利用時のトークン最適化:フロンティアモデルを使用せざるを得ない場合でも、質問内容や必要な回答量に応じて消費トークン数を最適化できる。まずはトークン構造を可視化することで制御が可能となり、たとえば前述の自動化やローカルLLMによって節約できたトークン枠を、他のユースケースへ柔軟に再配分できるようになる
これら3つの階層(自動化→ローカルLLM→フロンティアモデル)でクエリを振り分けることで、フロンティアモデルに到達する処理を全体の約20%以下に抑え、ユーザー一人あたり月額約10ドルという極めて低いコスト水準を実現しているとのことだ。
この記事は参考になりましたか?
- この記事の著者
-

名須川 楓太(編集部)(ナスカワ フウタ)
サイバーセキュリティとAI(人工知能)の分野を中心に、ソフトウェア/ハードウェアを問わず国内外の最新技術やルールメイキング動向を取材。そのほか、DX推進、IRなどのコーポレート領域でも情報を発信。※取材のご案内等は個人のメールアドレスか、EnterpriseZine編集部の問い合わせ窓口にお願いいた...
※プロフィールは、執筆時点、または直近の記事の寄稿時点での内容です

この記事は参考になりましたか?
この記事をシェア
